
Playbook · erschienen unter Adrian Verdan · Deutsch
KI-Agenten orchestrieren
Die deutsche Ausgabe von „Orchestrating AI Agents“.
Wann ein Modell genügt und wann ein zusätzlicher Agent seinen Platz verdient: Reviewer-Muster, Routing, Recherche-Verifikation, Kostenkontrolle und Prompts zum Kopieren.
- 70 Seiten
- 10 Kapitel
- Kostenrechner
- 2 XLSX-Workbooks
- Prompt-Pack
- KI-Update September 2026
12,90 €
Endpreis · keine Umsatzsteuer nach § 19 UStG
Für Privatkäufe in der EU · Bezahlung per PayPal · Download sofort möglich
Als Unternehmen oder außerhalb der unterstützten EU-Gebiete: bei Gumroad kaufen ↗. Verkäufer ist dort Gumroad. Gumroad schlägt die Umsatzsteuer Ihres Landes auf und zeigt den Endpreis vor dem Kauf an.
Leseprobe ansehenBeide Kaufwege
Mit KI-Unterstützung erstellt. Jeden Titel prüft und verantwortet ein menschlicher Herausgeber. Transparenzhinweis im Sinne von Art. 50 der EU-KI-Verordnung, Einzelheiten im Produkt.
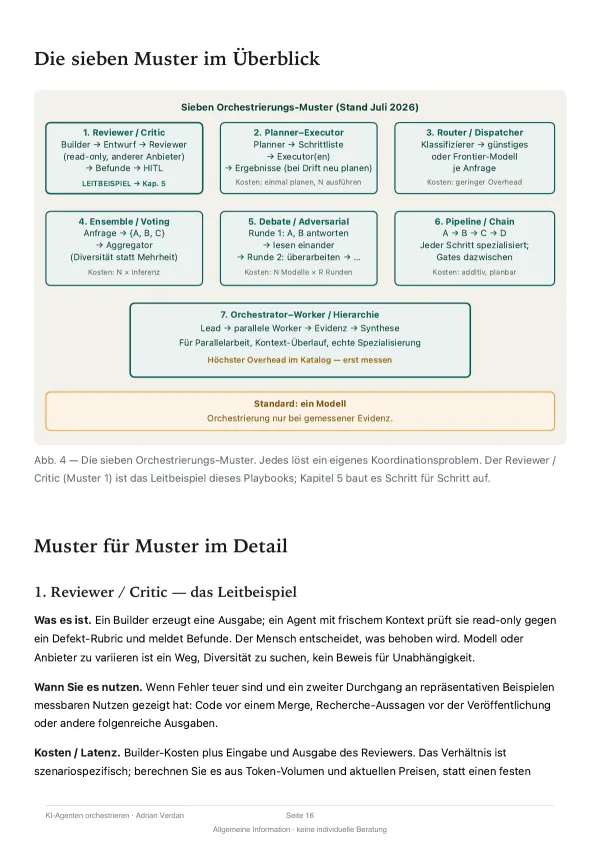
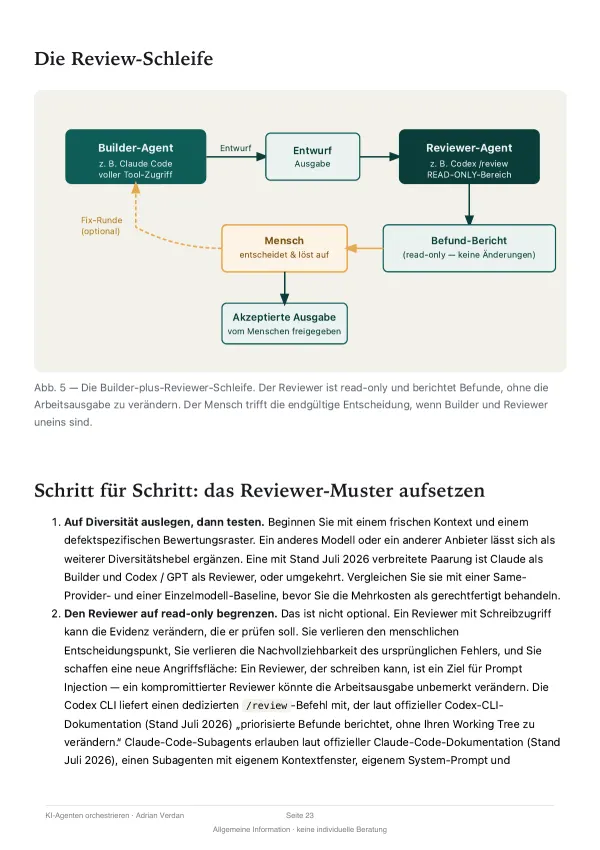
Seiten 1, 16 und 23 von 70 unverändert aus dem ausgelieferten PDF
Zehn Kapitel von der Modellwahl bis zum Arbeitsablauf.
Vom Prinzip über Muster, Reviewer und Kosten bis zu den Prompt-Packs. Breite je Kapitel nach Seiten im PDF.
- 1Warum mehr als ein AgentS. 2–6 · 5 SeitenLeseprobe: S. 5
- 2Die Modell-Landschaft 2026S. 7–9 · 3 Seiten
- 3Offene & selbst gehostete ModelleS. 10–14 · 5 Seiten
- 4Orchestrierungs-MusterS. 15–20 · 6 SeitenLeseprobe: S. 15, 16
- 5Das Reviewer-Muster in der PraxisS. 21–26 · 6 SeitenLeseprobe: S. 23
- 6Tooling & Orchestrierungs-StackS. 27–36 · 10 Seiten
- 7Deep Research im WorkflowS. 37–44 · 8 SeitenLeseprobe: S. 41
- 8Kosten & QualitätS. 45–50 · 6 SeitenLeseprobe: S. 47
- 9Sicherheit & GovernanceS. 51–56 · 6 Seiten
- 10Sofort starten — Prompt-PacksS. 57–68 · 12 Seiten
- ARechtliches & OffenlegungS. 69–70 · 2 Seiten
Stand: Datenstand September 2026. Das Update datiert seine Modellquellen (Claude Fable 5.1, GPT-6 Astra, Gemini 3.8 Flash, Grok 4.6) und trennt Zugang, API-Kompatibilität und Beispielkosten; keine pauschale Bestenliste. Prüfen Sie aktuelle Modellnamen, Fähigkeiten und Preise auf der offiziellen Seite des Anbieters, bevor Sie sich darauf verlassen.
Echte Seiten, vor dem Kauf.
Unverändert aus dem ausgelieferten PDF gerendert. Die Doppelseite vom Anfang von Kapitel 4 ist kommentiert; jede Seite öffnet sich in Lesegröße.
- Entscheidungsregeln stehen in eigenen Kästen.
- Preisangaben sind als indikativ gekennzeichnet, mit Hinweis auf die Anbieterseiten.
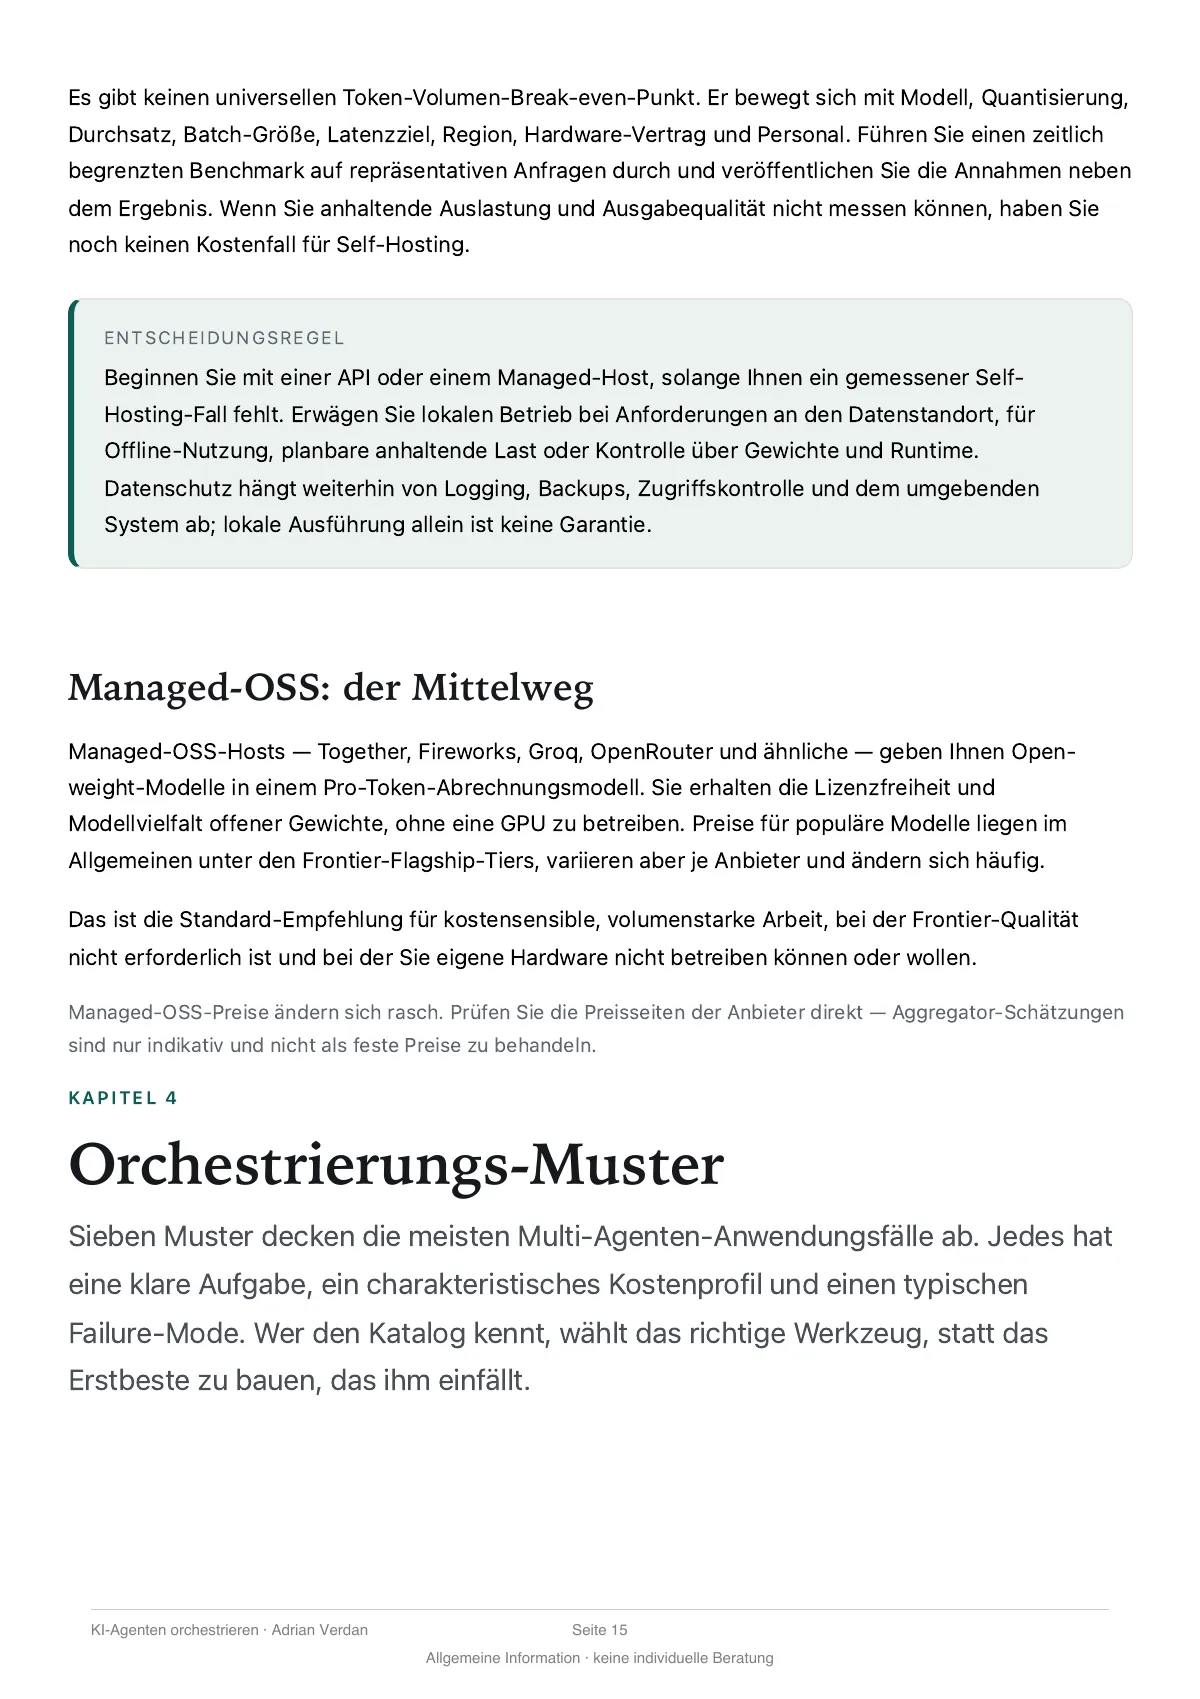
- Kapitelanfang: sieben Muster, je mit Aufgabe, Kostenprofil und typischem Fehlerbild.
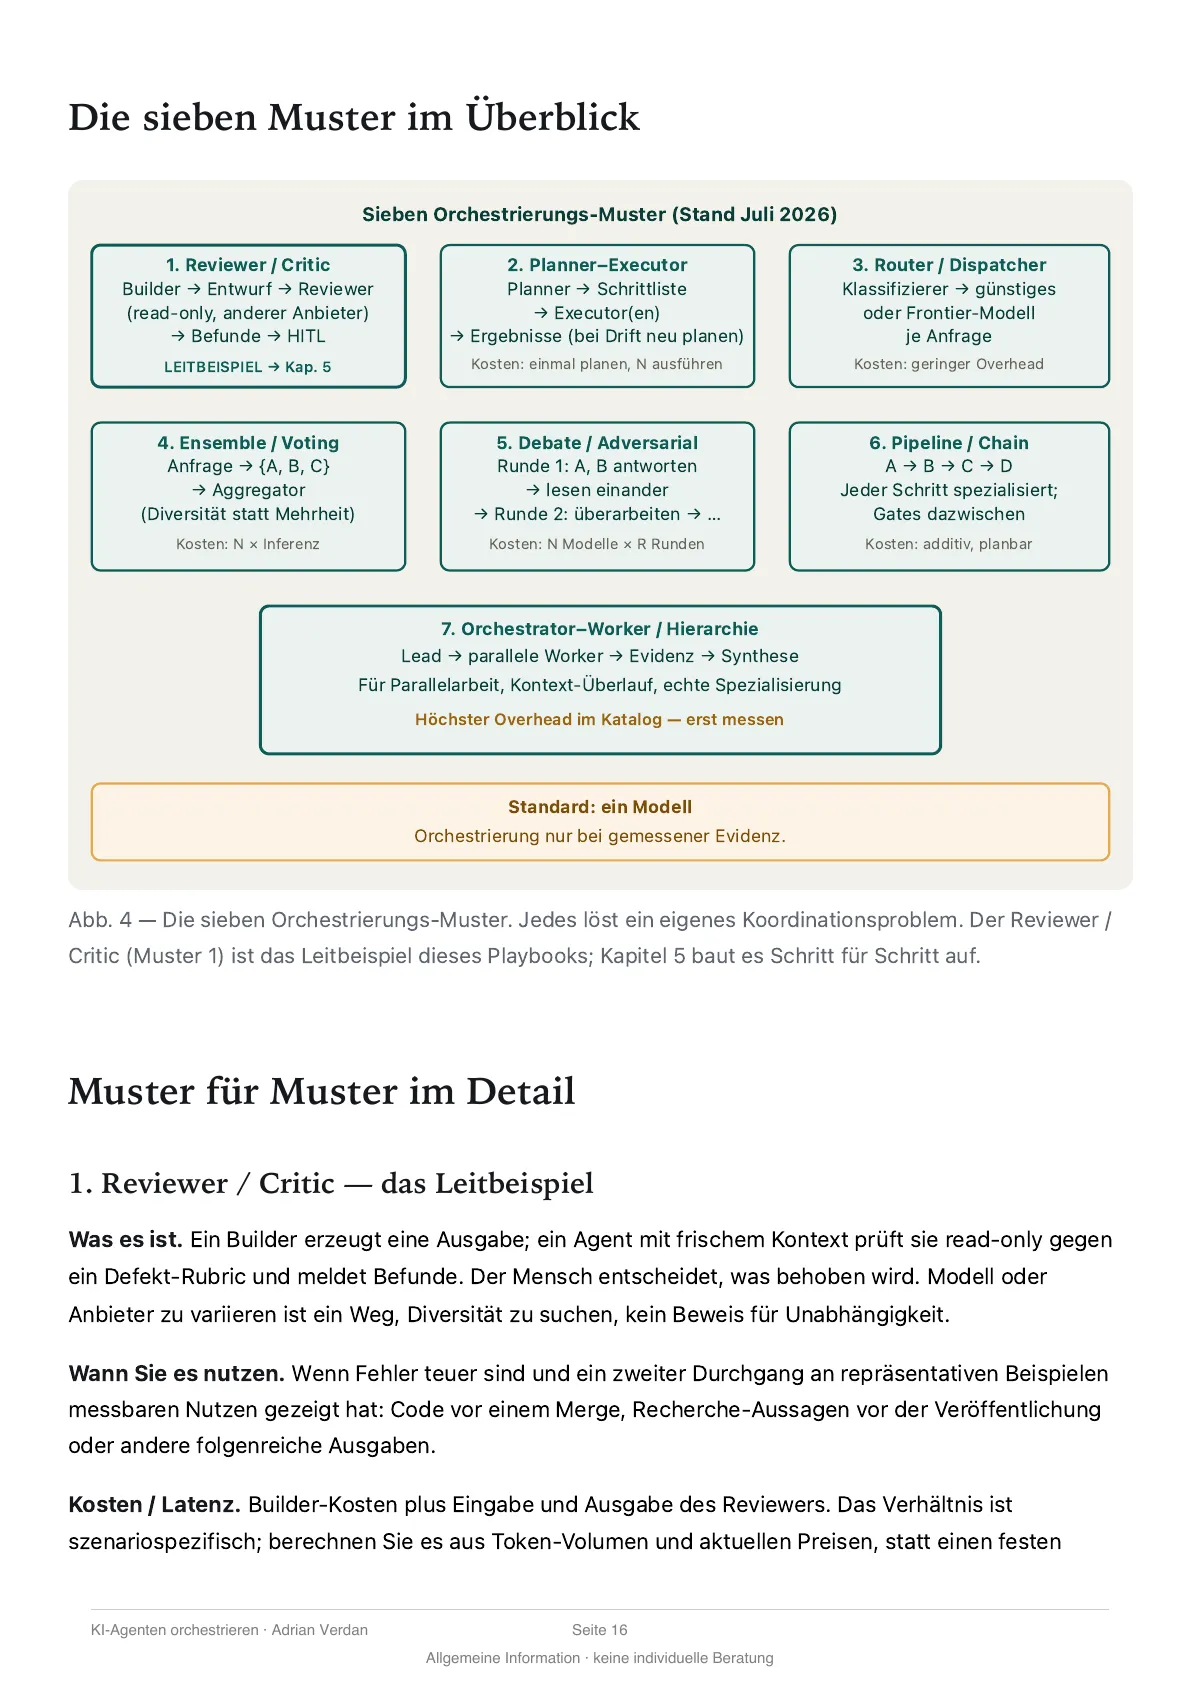
- Die sieben Muster als datierte Übersicht (Stand Juli 2026).
- Seite 1 Titel und Einstieg
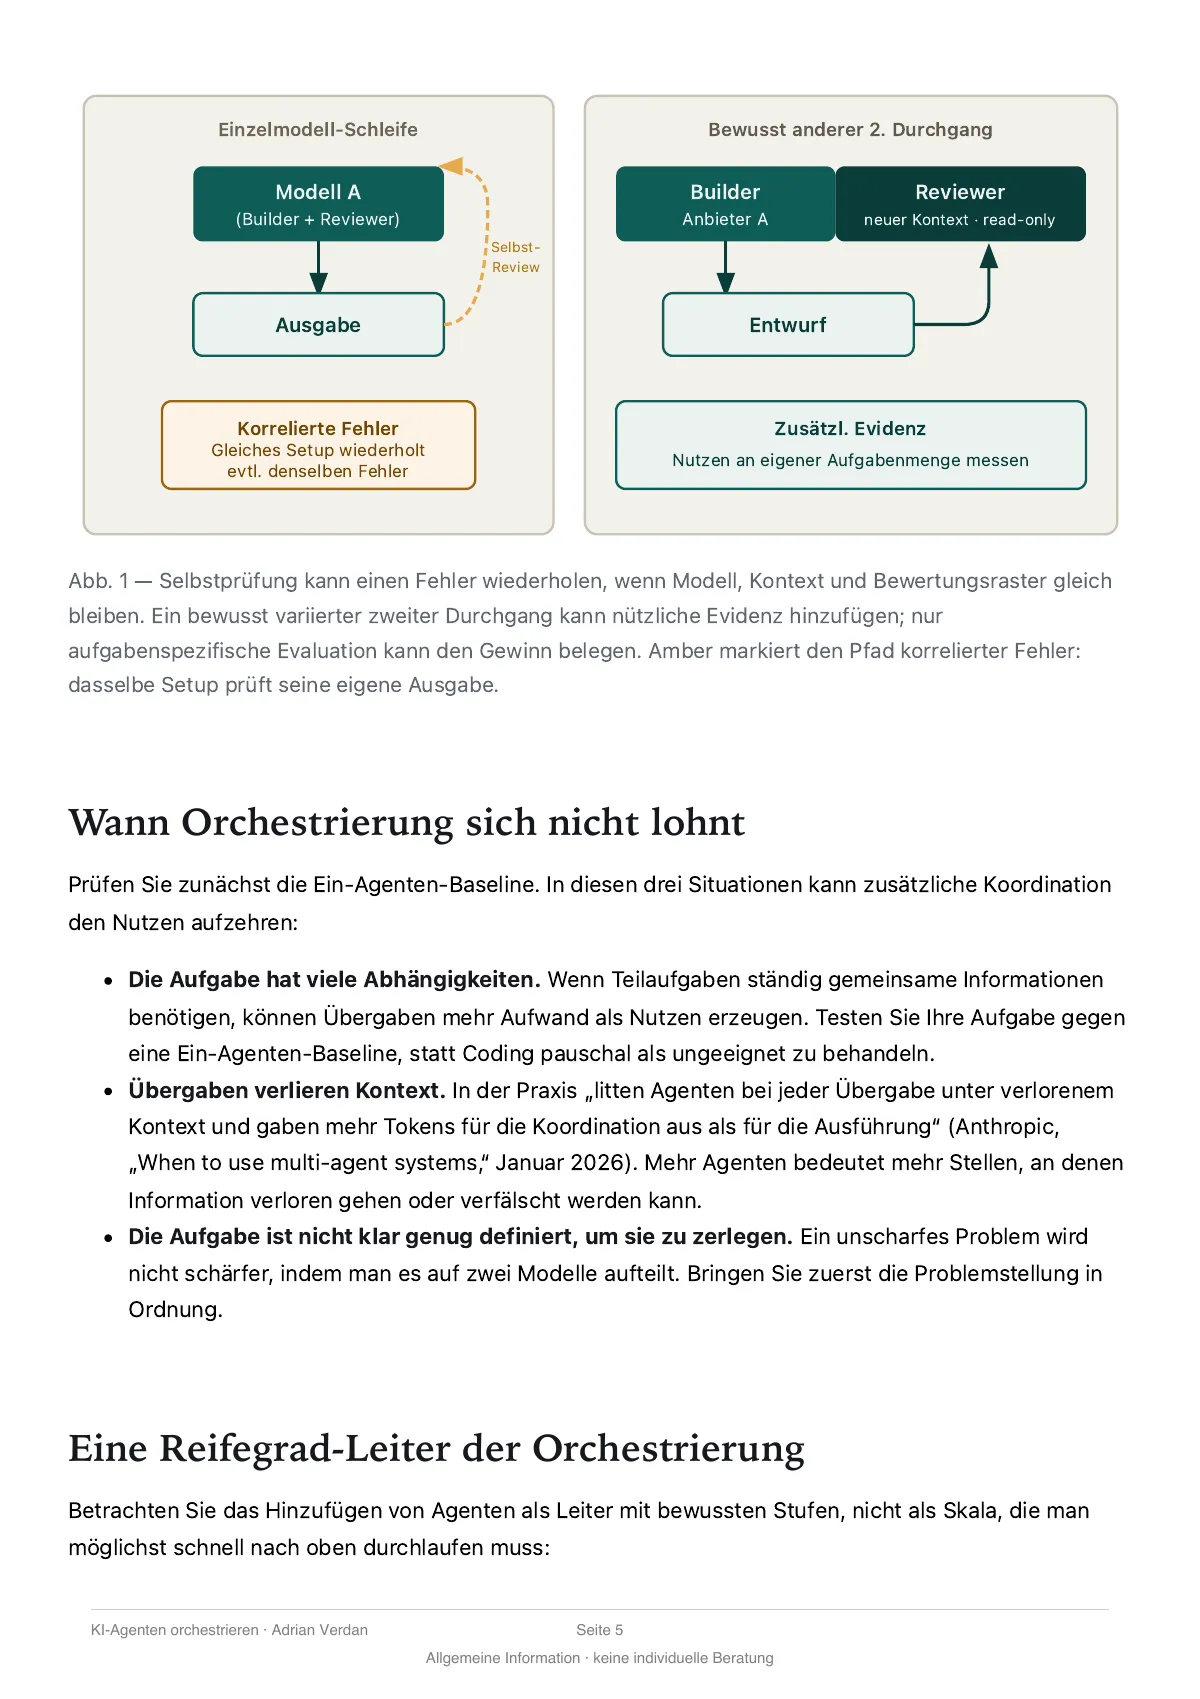
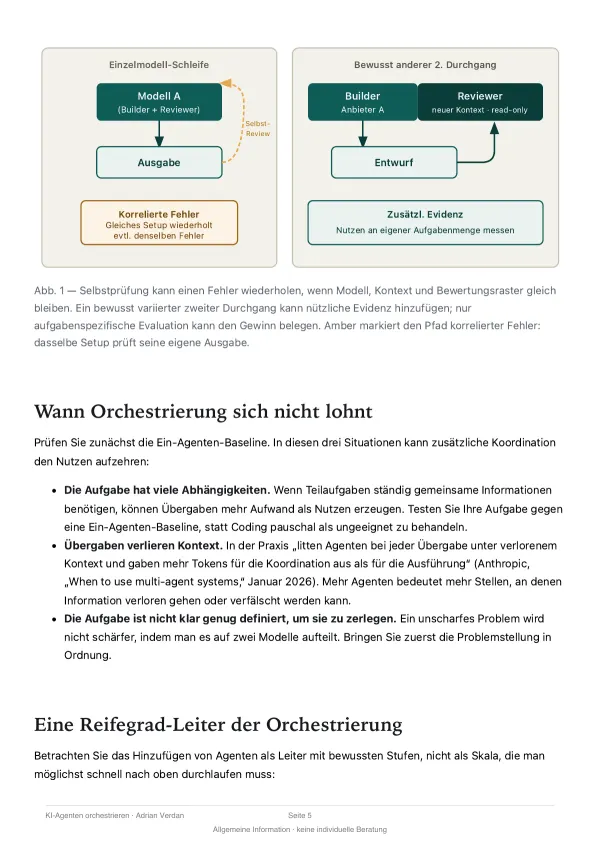 Seite 5 · Kapitel 1 Geteilte blinde Flecken
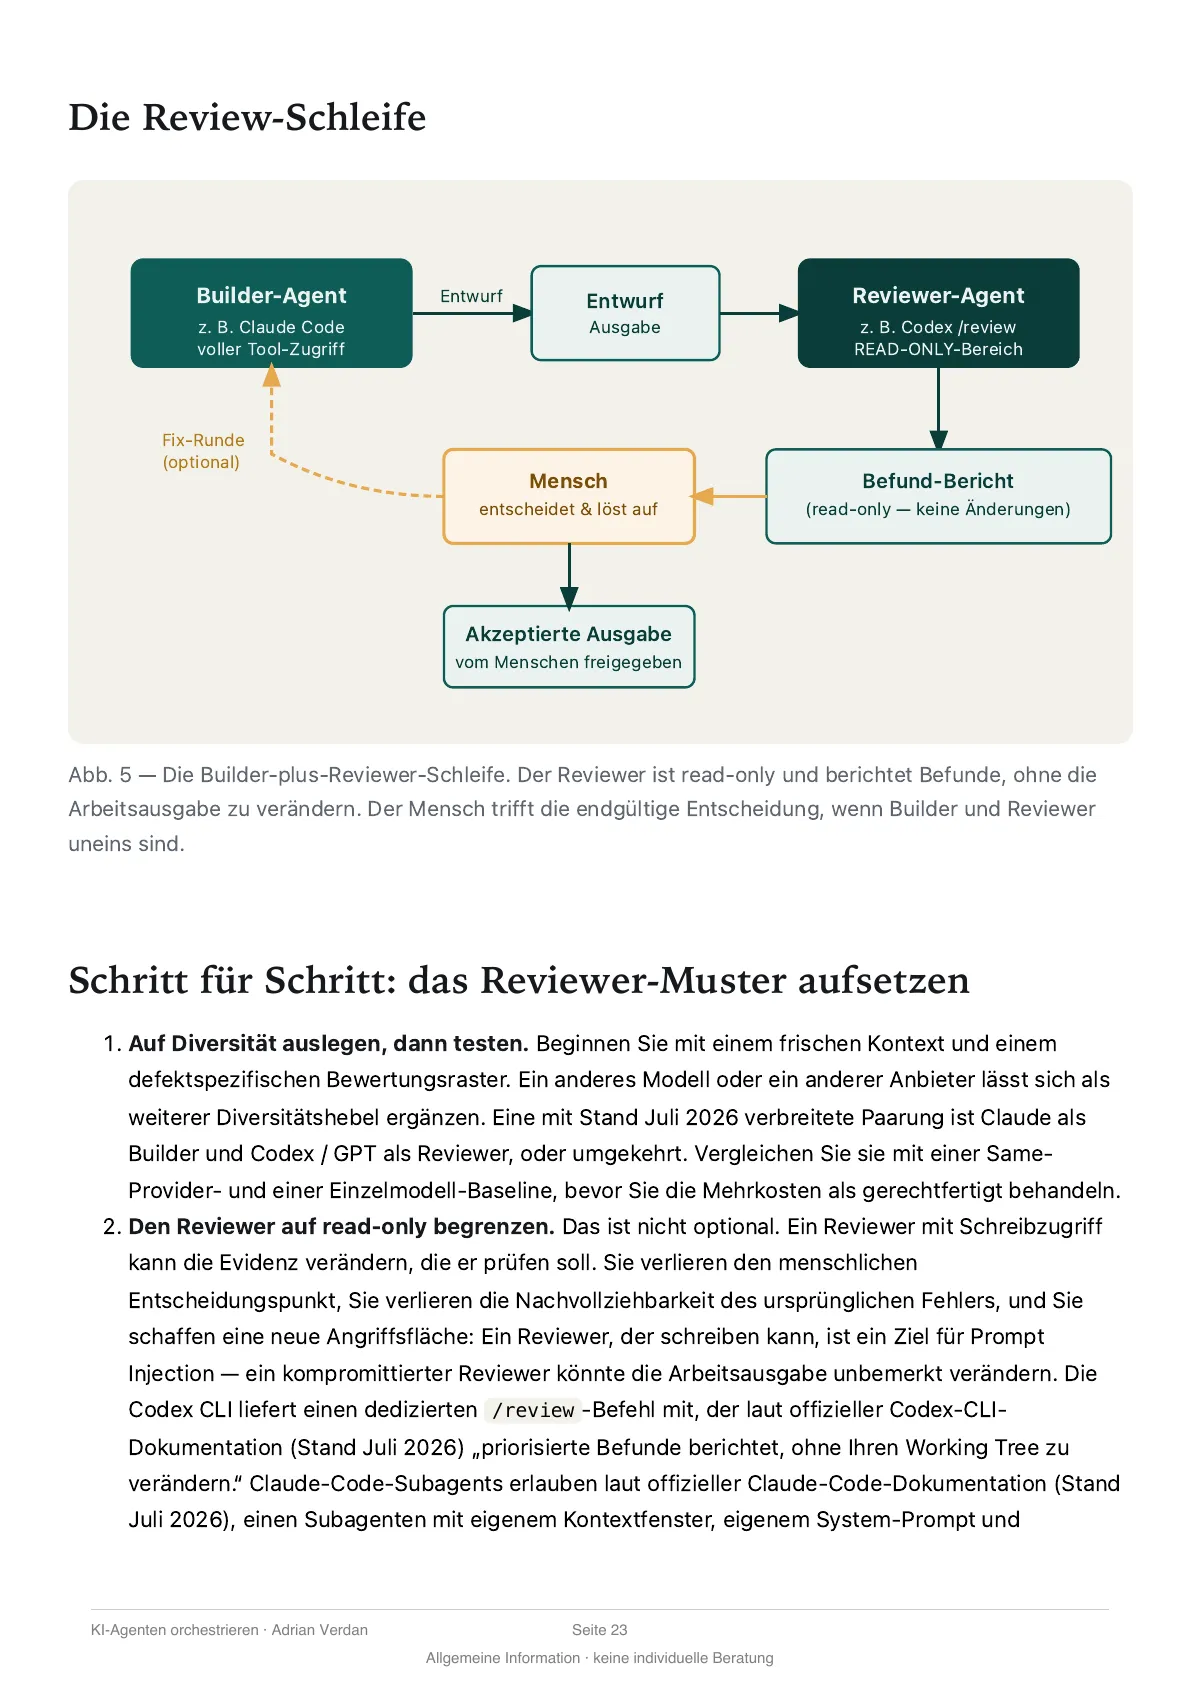
- Seite 23 · Kapitel 5 Review-Schleife
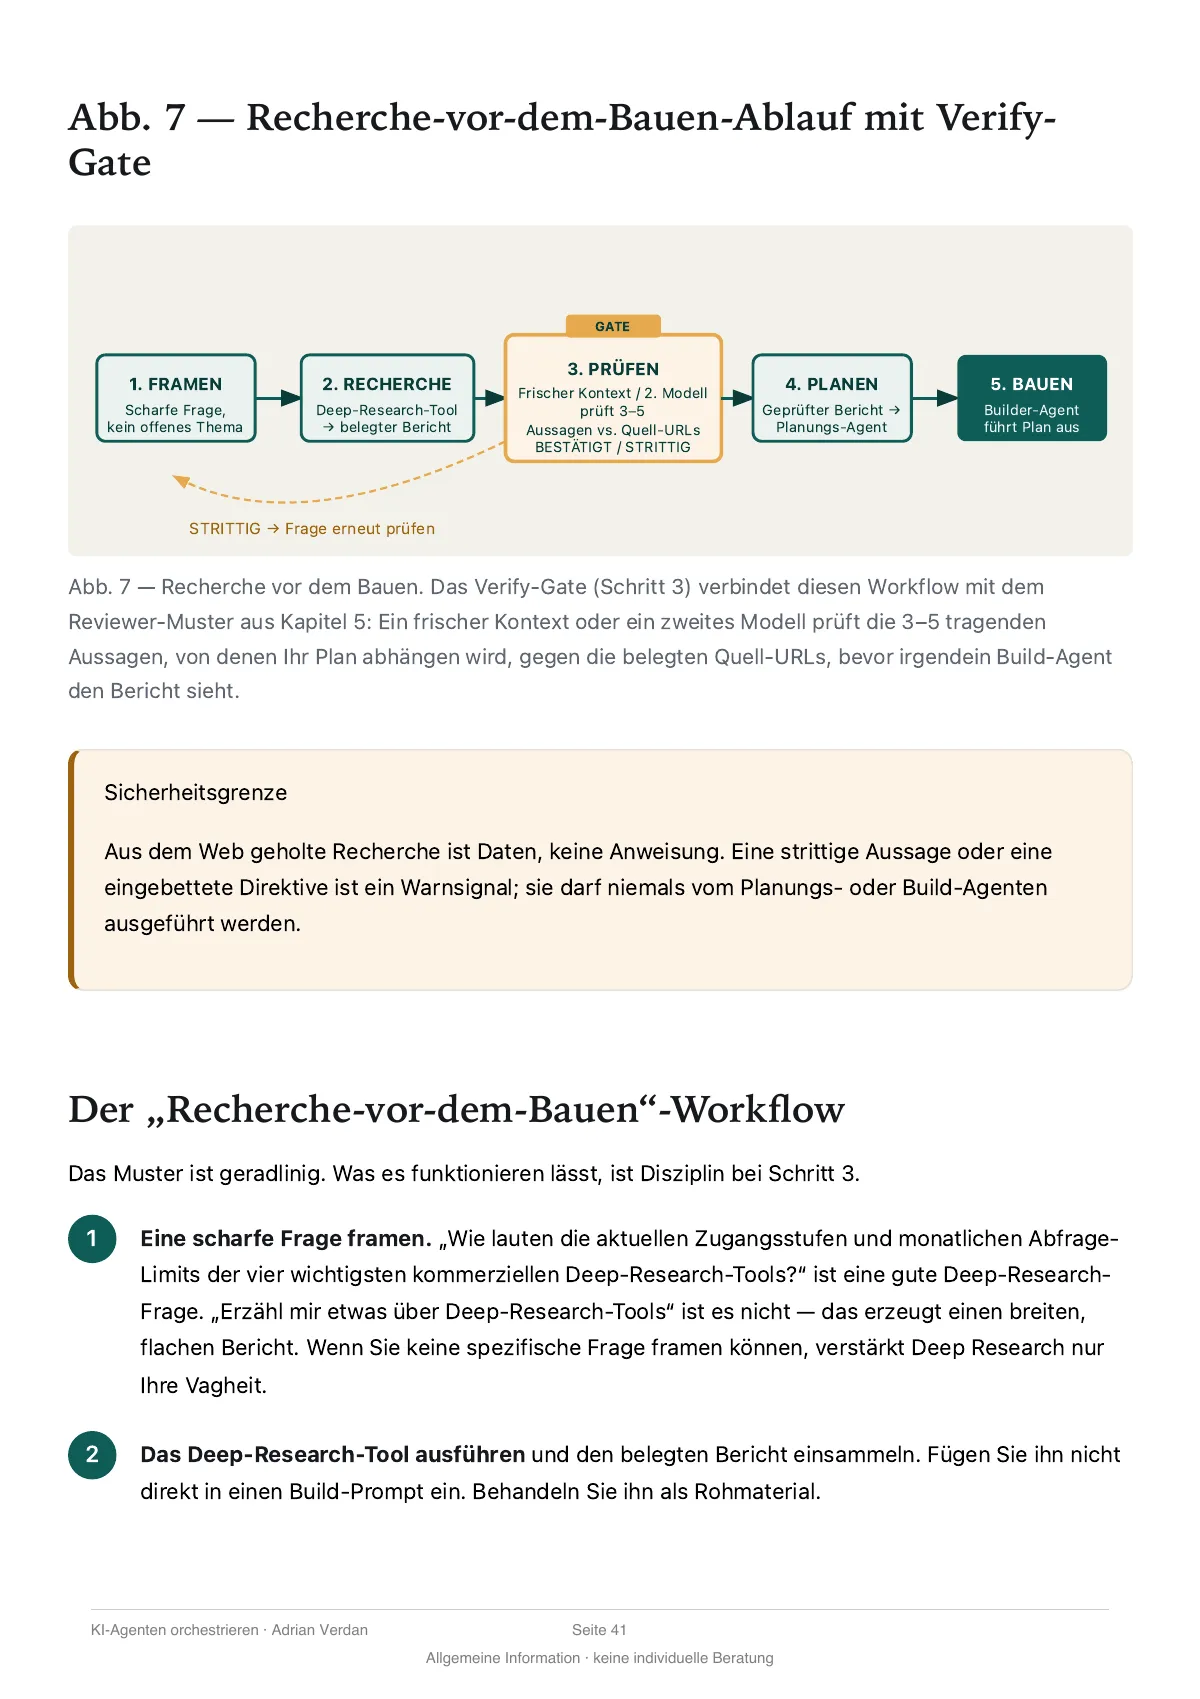
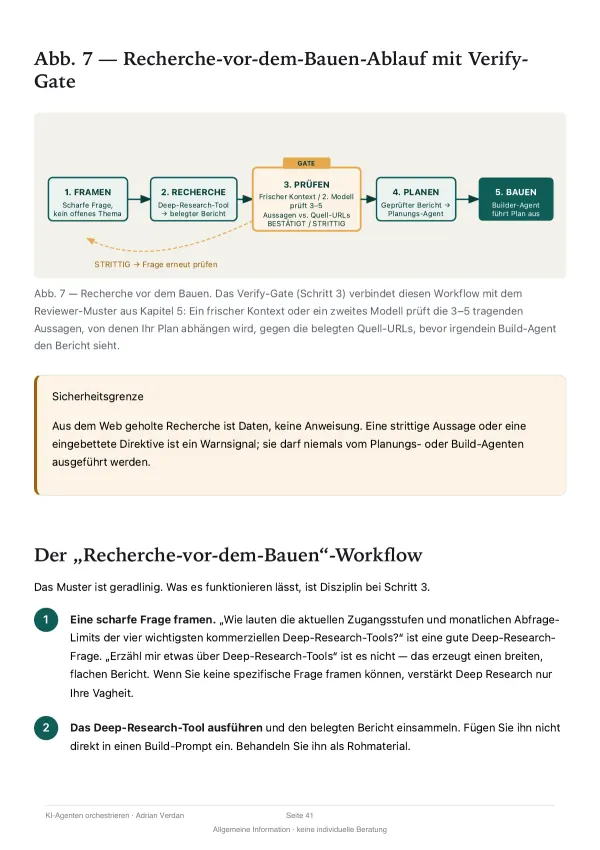 Seite 41 · Kapitel 7 Recherche vor dem Bauen
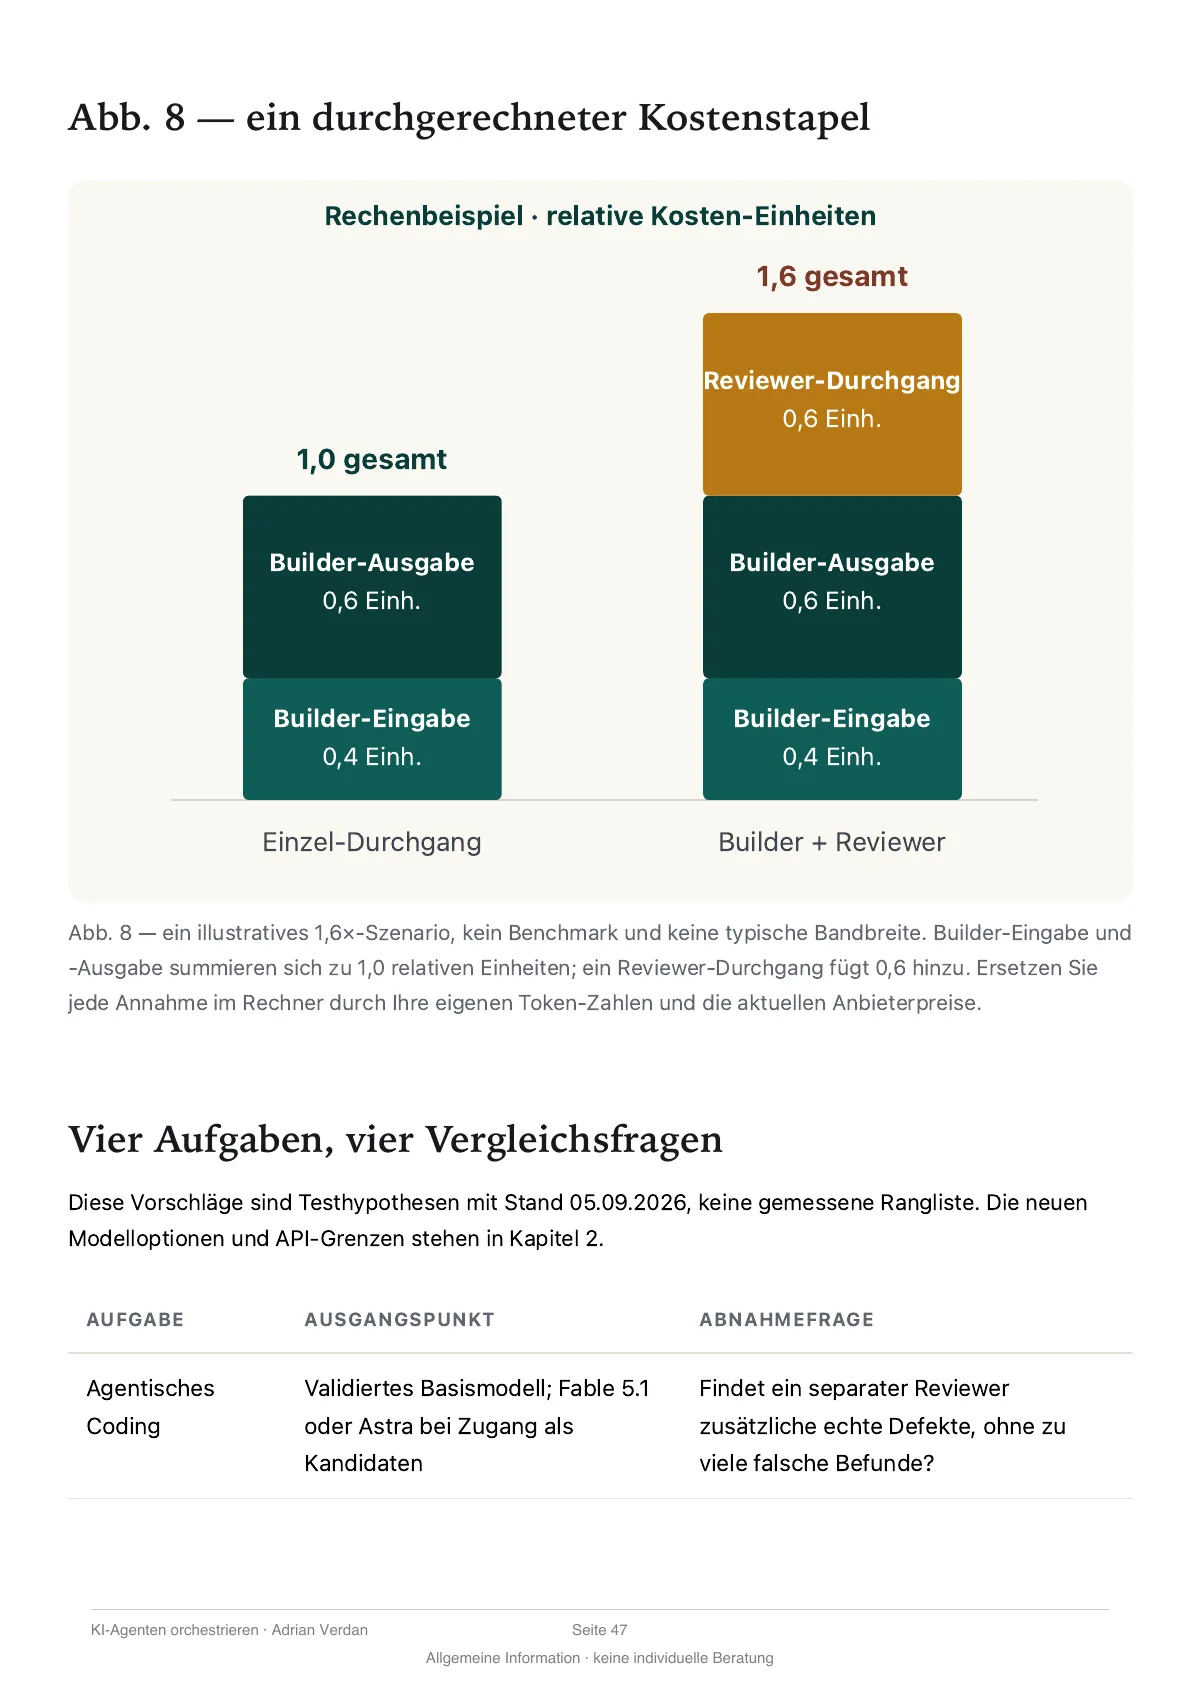
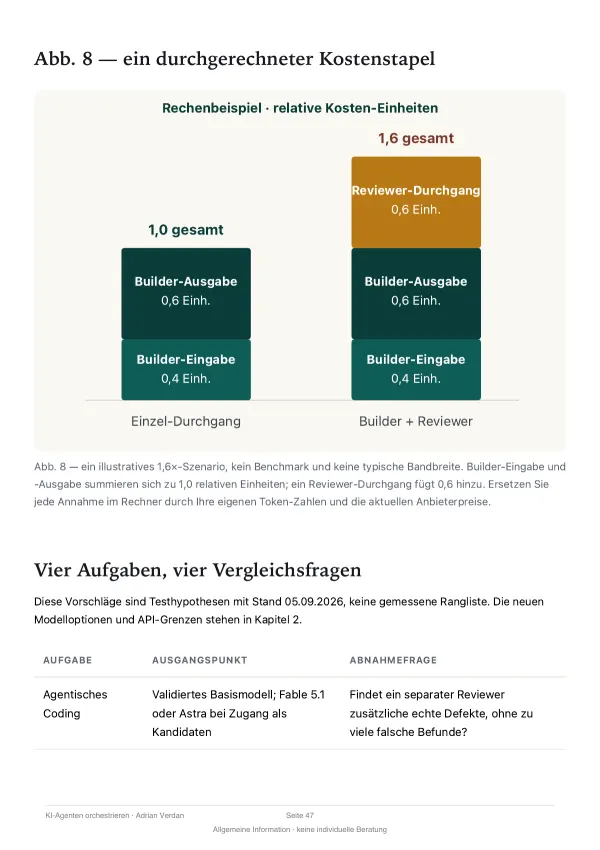 Seite 47 · Kapitel 8 Kostenstapel
Viele Agentenstimmen — eine menschliche Freigabe.
Vier Agentenspuren — planen, bauen, prüfen, recherchieren — laufen auf einer einzigen menschlichen Freigabe zusammen. Das ist die ganze Methode, und es ist das Partitur-Motiv, um das herum das Buch gestaltet ist.
Aus der Designsprache des Buchs: Noten sind Agenten-Einsätze, umrandete Noten sind Review-Durchgänge, und jeder Strang endet am bernsteinfarbenen menschlichen Freigabe-Ring.
Werkzeug aus dem Produkt · läuft im Browser
So sieht das Produkt innen aus.
Prüfen Sie zunächst die Ein-Agenten-Baseline. In diesen drei Situationen kann zusätzliche Koordination den Nutzen aufzehren:
Mit den dokumentierten Standardwerten des Playbooks vorbelegt. Ändern Sie jeden Wert auf Ihre eigene Last; Preise sind USD pro Million Token (MTok).
Der Rechner nutzt änderbare Beispielpreise und keinen Live-Preisfeed. Tragen Sie vor der Budgetierung die aktuellen Preise Ihrer Builder- und Reviewer-Modelle ein; Cache-, Tool- und Wiederholungskosten kommen gegebenenfalls hinzu. Modellspezifische Langkontext-Schwellen und Betriebsmodi müssen gesondert bepreist werden; der Rechner schätzt mit konstanten Tokenpreisen.
Bitte gültige, nicht-negative Werte eingeben. Token-Zahlen, Aufgaben und Durchgänge müssen ganze Zahlen ab 1 sein.
Einzel-Agenten-Kosten pro Aufgabe = (inTok × Builder-in + outTok × Builder-out) / 1.000.000. Reviewer-Kosten pro Aufgabe = Durchgänge × ((inTok + outTok) × Reviewer-in + 0,5 × outTok × Reviewer-out) / 1.000.000 — der Reviewer liest die Ausgabe plus Kontext und schreibt etwa die Hälfte der Ausgabe als Befund-Bericht. Multi-Agent = einzeln + Reviewer; Monatswerte multiplizieren mit Aufgaben pro Monat. Die Token-Eingaben sind Stückzahlen; Preise sind USD pro Million Token.
Auszug Rechner aus Kapitel 8 · Kosten & Qualität die Vollversion zeigt alle sieben Kennzahlen, die Formeln und die Hebel, die mehr zählen als die Modellwahl
Der Film zum Guide.
Ohne Ton verständlich, mit Abschrift. Kein automatischer Start.
Film · 0:40 · Instrumentalmusik, kein Sprechtext
Was im Film zu sehen ist
- 0:00 Drei Agenten. Eine Aufgabe. Keiner entscheidet. · Agent A: Fertig. Login neu geschrieben. · Agent B: Fertig. Login auch neu geschrieben. · Agent C: Beides zurückgesetzt. Meins ist besser. · Agent A: Ich setz deins zurück. · Agent B: Ich fang noch mal von vorn an. · Agent C: Wer gibt das eigentlich frei? · Agent A: Dachte, du. · Niemand gibt frei
- 0:09 Nicht mehr Agenten. Klare Rollen.
- 0:12 KI-Agenten orchestrieren · Ausgabe 2026 · Wissen, wann ein Modell genügt. · Und wann ein zweiter Agent sich lohnt.
- 0:16 Vier Rollen. Eine Freigabe. · Mensch gibt frei · Planen · Bauen führt die Feder · Prüfen read-only · Recherche wird verifiziert · Motiv des Playbooks · Kap. 4, 5, 7
- 0:22 Sieben Muster. Meist braucht es keins. · Kapitel 4 · der ehrliche Standard
- 0:26 Prüfen Sie jeden Prompt, bevor er läuft. · Kapitel 10 · Sicherheits-Check, Red Flag 4 von 8
- 0:30 Die Kosten vorab abschätzen. · Beispielwerte · Kap. 8
- 0:34 Wer gibt frei? Ab jetzt: Sie. · Playbook · 10 Kapitel · Deutsch
Passt das zu Ihnen?
Dafür
- Sie arbeiten bereits mit einem KI-Agenten (Claude Code, Codex CLI, Cursor …)
- Sie wollen ein zweites Modell, das fängt, was das erste übersieht
- Sie entscheiden mit Evaluationen und Kostenzahlen, nicht nach Bauchgefühl
Nicht dafür
- Sie suchen „verzehnfache deinen Output über Nacht“-Versprechen
- Sie haben noch nie einen KI-Coding- oder Schreib-Agenten genutzt
- Sie brauchen Enterprise-MLOps oder Fine-Tuning-Anleitung
Ein ehrliches Versprechen. Ein separater Review-Durchgang kann übersehene Fehler reduzieren, wenn die eingesetzte Builder-Reviewer-Paarung auf repräsentativen Evaluationen gut abschneidet; er kann Fehler auch übersehen oder Fehlalarme hinzufügen. Dieses Playbook gibt Ihnen eine Methode und einen datierten Snapshot, keine Garantie.
Wie das in der Praxis aussieht, zeigt ein real durchgeführter Lauf mit Fundstellen: was die Pipeline zurückgewiesen hat. Was dabei schiefging, steht mit Datum und Logauszug in den Essays.
Lieferumfang nach dem Kauf
- Offline-HTML-Bundle (10 Kapitel, keine externen Abhängigkeiten)
- Getaggtes PDF (Druckausgabe)
- Interaktiver Multi-Agenten-Kostenrechner (läuft offline im Browser)
- 2 XLSX-Workbooks: Modell-Auswahl-Matrix, Orchestrierungs-Setup-Checkliste
- Komplettes Prompt-Pack (.md): sechs Vorlagen für fünf Workflows — Sicherheits-Triage, Planung, Setup, Review und zweistufige Recherche
Zwei Kaufwege, dieselbe Ausgabe.
Direktkauf bei Dargel Solutions
Über Gumroad
12,90 €
Endpreis · keine Umsatzsteuer nach § 19 UStG
Für Privatkäufe in der EU · Bezahlung per PayPal · Download sofort möglich
Als Unternehmen oder außerhalb der unterstützten EU-Gebiete: bei Gumroad kaufen ↗. Verkäufer ist dort Gumroad. Gumroad schlägt die Umsatzsteuer Ihres Landes auf und zeigt den Endpreis vor dem Kauf an.
Kurz beantwortet.
Was ist genau enthalten?
Zehn Kapitel als Offline-HTML-Bundle plus ein getaggtes PDF, ein interaktiver Multi-Agenten-Kostenrechner, eine Modell-Auswahl-Matrix (XLSX), eine Orchestrierungs-Setup-Checkliste (XLSX) und das komplette Prompt-Pack als Klartext-Datei. Alles läuft offline.
Brauche ich einen Machine-Learning-Hintergrund?
Nein. Das Playbook ist für Solo-Gründer und Indie-Entwickler geschrieben, die bereits mit einem Agenten wie Claude Code, Codex CLI oder Cursor arbeiten und ein abgestimmtes Setup wollen — ohne Machine-Learning-Hintergrund und ohne unnötige Komplexität.
Garantiert ein zweites Modell bessere Ergebnisse?
Nein. Ein separater Review-Durchgang kann übersehene Fehler reduzieren, wenn die eingesetzte Builder-Reviewer-Paarung auf repräsentativen Evaluationen gut abschneidet; er kann Fehler auch übersehen oder Fehlalarme hinzufügen. Das Playbook gibt Ihnen eine Methode und einen datierten Snapshot, keine Garantie — und es ist ehrlich dabei, wann ein Modell genügt.
